

模型之外,数据库成了新的胜负手
原创 月满西楼 | 2026-11-04 21:59
【数据猿导读】 “数据平台的下一轮竞争,是让Agent理解得准、执行得稳、边界可控。
“数据平台的下一轮竞争,是让Agent理解得准、执行得稳、边界可控。
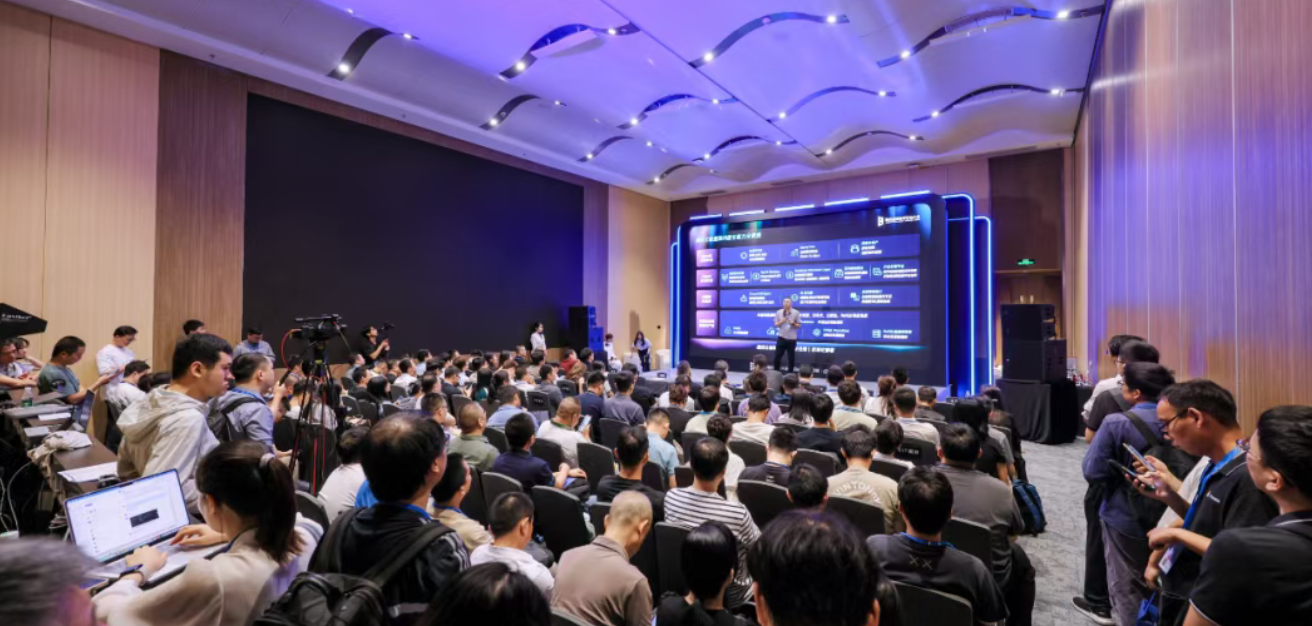
10月30日的腾讯全球数字生态大会“AI原生数据库专场”重磅发布TDSQL Nexa Lakebase,定位AI原生多模数据库,受到诸多关注。
自从大模型把Agent推到台前之后,数据库要面对的“用户”开始从人变为Agent。
这个变化,值得展开讲。过去几十年,数据库服务的都是人,人写SQL、看报表、做决策,数据库只需要把结果存对、算对。而Agent是一种完全不同的用户,它要读懂数据、理解业务,还要动手写数据。企业买数据库,买的也不再只是一套存储软件,而是Agent干活的底座。
底座跟不上,模型能力的提升也无法带来真正的业务价值。在本轮AI浪潮中,大量的企业在落地开发Agent时发现:卡住项目的往往不是模型能力,而是自己攒了十几年,但孤立、缺乏治理的数据家底。腾讯云把这场发布会的主题定为AI原生数据库,意图很明确,数据库要面向Agent进行架构演进。
接下来,我们先看行业为什么到了重做的关口,再看这次腾讯给出的答案成色几何。
模型越来越强
企业的数据却没准备好
过去一年,Agent是企业级市场最热的词。几乎所有叫得出名字的企业都在做演示项目,Demo一个比一个惊艳。但真正跑进生产环境的比例并不高,多数项目停在试点阶段。
钱花了,人投了,为什么上不了线?据我们观察,多数企业不缺数据,缺的是Agent读得懂、信得过、用得对的数据底座。具体来说,这笔账可以分三笔来算。
第一笔是拼接账。
一家典型企业的数据现状是,订单躺在关系型数据库里,文档存在对象存储上,向量存储在专门的向量库里,日志又在另一套系统。一次业务问答要跨三四个系统取数,中间靠一堆同步任务维持。每新增一个Agent应用,这套拼接工程就要重来一遍,成本线性增长。
更麻烦的是,同一份数据在多个系统里各存一份,副本之间的同步时延往往导致Agent拿着过期信息做出错误判断。
第二笔是理解账。
就算把数据拼起来了,Agent也未必看得懂。例如,表名是缩写,字段没有解释,“华东收入达成率”这样的业务指标散落在文档和少数专家的脑子里。这也是为什么Text-to-SQL在公开数据集上表现惊艳,一到真实企业库准确率就明显下滑。公开数据集自带说明书,企业库只有沉默的表结构。人可以开口问同事,Agent只能猜,猜错一次,整条业务链路可能就废了。理解账是最隐蔽的一笔,性能监控管得住系统,管不住语义,它不体现在采购清单上,只在Agent上线后的每一次错误回答里显形。
第三笔是风险账。
早期的Agent以只读为主,顶多查错数据。现在的Agent要真正干活,创建记录、更新库存、执行交易,误删、越权就从“小概率事故”变成了必须兜底的安全命题。不少企业因为这个顾虑,干脆把Agent限制在只读权限里,但只读的Agent价值有限,业务闭环终究要落在写上。
三笔账叠在一起,指向同一个结论。企业之间的AI竞争,正在从“谁的模型强”转向“谁的数据底座先准备好”。
TDSQL Nexa Lakebase
把多模数据重做一遍
面对这三笔账,行业的普遍做法是“缝”。将现有的数据库通过外部的同步链路对接独立向量库,自己维护数据管线。缝的好处是改动小、上线快,但天花板绕不开,所有能力都建立在多套系统之上,拼接的复杂度随场景增多而累积,不会消失。
腾讯云的思路,有点不同。
Nexa回到原点思考一个问题,如果今天从零设计一个给Agent用的数据库,它应该长什么样?他们的答案是一套系统要同时能干四类活:在线业务读写、数据分析、语义搜索、数据加工。过去客户要自行拼接四种数据库,现在由宽表、分析、搜索、AI计算四类引擎在一套系统里完成。企业存量数据直接接入纳管,底层用开放格式存储。

TDSQL Nexa产品架构
那这套新思路,具体怎么实现呢?拆开看,这个设计可以对应三个命题。
命题一:共用一份数据,不再四处搬家
行业的老模式是一种负载配一套系统,系统之间靠外部任务搬运数据。它的死结不在技术,在组织。同步任务需要运维工程师自主搭建,冗杂的同步管线加之多技术栈带来的复杂性,带来的是更高的故障率和居高不下的维护成本。招更多人、买更好的工具,都是在为落后的技术架构买单。
Nexa的解法,是将复杂交给数据库产品闭环。业务写入主引擎之后,与搜索、分析的索引同步由系统搭建和维护。这个改动看着不起眼,本质是把同步从一项“工程”降格为一项“功能”。
某头部车企的智驾场景,是个直观例子。训练数据链路原本横跨多套系统,原始数据要解析、抽帧、打标、向量化才能变成样本,标签还随模型迭代不断调整。收敛到Nexa一套系统后,新增标签直接在宽表列横向动态扩展,异构索引的维护由系统闭环,数据集构建效率提升10倍以上。
命题二:让Agent读懂企业业务
统一存储解决数据拼接问题,如何理解数据要靠另一层能力。Nexa Knowledge的思路,是把企业里“口口相传”的业务知识变成可管理和维护的数据资产,Agent的起点从“猜字段”变成“查企业的业务词典”。
需要指出的是,数据资产不是一成不变的,而是要随企业发展跟随演进的。Nexa Knowledge定时监控数据变化,数据结构变了就自动感知。同时结合交互式问答,让业务人员在问数过程中就可以不断订正业务语义,让Agent越问越准。
某教育客户的智能问数场景落地后,问答准确率提升60%以上。对智能问数这类直接面对业务人员的产品来说,这个量级的准确率改善,往往就是demo与生产的分界线。
命题三:数据加工成为数据库分内事
大模型时代的数据,入库只是开始。多模数据的解析、切分、打标、向量化,维护在外部集群。用户要自行购买算力资源,维护数据管线。Nexa的AI计算引擎把加工收进产品体系内,算力开箱即用。冷数据预热、故障后断点续跑让GPU利用率更高。
从更长周期看,命题三改变的是成本结构,选型、拼接、算力闲置的成本一起降低,数据准备从“项目制”变成“服务制”。这正是云数据库当年颠覆软件部署的逻辑,这一次轮到了AI基建。

梁辰 腾讯云数据库副总经理
国产数据库中心负责人主题演讲
Nexa不是孤军,全栈家族各守一层。
此次大会发布的不只是Nexa,而是面向AI原生的全栈数据库产品升级。
TDSQL Boundless统一承载多模态数据,一套内核兼顾事务、宽表、分析、搜索与语义检索;支持冷数据归档,一条SQL把冷数据转存到对象存储,成本约为本地盘的八分之一。
TDSQL-C提供Serverless的后端数据库服务,支撑Agent运行,无连接时缩容到零,秒级冷启动;数据分支基于写时复制,PB级数据克隆约1秒,让每个Agent可以在独立分支上试错,多Agent沙箱为每个Agent分配独立实例,秒级拉起、即用即焚。
TencentDB Agent Memory管的是上下文记忆,利用L0到L3四层记忆架构,让Agent跨会话延续用户背景和任务信息,还能沉淀团队记忆资产,项目自开源后多次登顶GitHub排行榜第一,已获得全球超3w star关注。
跑起来之后,还要让Agent接手DBA的工作。TencentDB Agent把腾讯云数据库多年运维经验封装为Skill,以10万级工单持续沉淀经验,操作不出域,分四级权限分层执行,只读自动跑、变更需确认、高危动作直接拒绝。
各项能力协同,覆盖数据存储、运行支撑、语义理解、记忆沉淀与运维管理,让Agent存得住、跑得动、看得懂、记得住、管得好。
湖与库的融合
已是全球共识
将视野拉远,腾讯云在数据库与AI融合上的探索并非孤例。
Databricks推出面向Agent的Serverless Postgres产品Lakebase,Snowflake以Unistore混合表补齐事务能力,Oracle在26ai中融合向量检索与事务处理。他们的技术路径虽有差异,但方向日益趋同:数据平台不仅要供人查询分析,更要支持Agent理解业务、执行任务。
从整个产业来看,数据库正在从业务系统的基础软件,走向智能应用的关键基础设施。AI不仅带来新需求,更在拓展数据库的价值边界。
TDSQL Nexa Lakebase给出的答案是完整的:它以对象存储为统一数据底座,以宽表、搜索、分析、AI计算多引擎为计算骨架,以智能编排路由和Knowledge语义层为统一入口,让企业在同一套系统里完成多模数据的存储、加工、检索与分析,并为Agent提供真正可用的数据底座。
此外,腾讯云数据库还披露了一组数据,过去一年,由Agent创建的腾讯云数据库PG平均日增超2万,增速超过80倍,活跃实例突破100万。需求增长与厂商布局共同表明,Agent对数据基础设施的要求,已不再停留于概念讨论。
结语
回看数据库六十余年的演进,贯穿其中的不只是技术更迭,更是数据使用者与需求的变化。
从早期面向账务和记录管理,到关系模型以严谨的数据模型与事务机制支撑企业精确查询;从互联网时代NoSQL与分布式架构应对海量访问,到云原生时代存算分离降低使用门槛——数据库的每一次演进,都呼应着数据形态、访问规模与使用方式的变化。
如今,Agent正成为新的数据使用者。TDSQL Nexa迈出的这一步,正是回应了AI时代的数据库,不只要存得稳、查得快,还要管得住、找得到、算得动、能协同——让Agent真正读懂企业数据。
文:月满西楼 / 数据猿
责编:凝视深空 / 数据猿
来源:数据猿
刷新相关文章
































我要评论
不容错过的资讯



大家都在搜


