

搞点专有数据,就能做主权AI?
几重山月 | 2026-10-14 21:38
【数据猿导读】 “把别人的模型喂上自己的数据,就能拥有真正的主权AI吗?

“把别人的模型喂上自己的数据,就能拥有真正的主权AI吗?
近期,新美国安全中心(CNAS)发布《“主权AI”的第二波正在显现》(SovereignAI’s Second Wave Is Coming Into View)。根据其“主权AI指数”,截至2026年上半年,全球已有67个国家推进184个政府支持的主权AI项目。仅2026年上半年,就新增41个项目,数量已经超过2024年全年。
“主权AI”从一个相对专业的概念,迅速成为全球政策和产业讨论中的热词。顾名思义,主权AI意味着一个国家希望拥有能够自主开发、自主部署、自主管理和自主控制的人工智能系统,而不是完全依赖外国企业提供模型、数据和算力。
各国之所以强调“主权”,首先是因为AI已经不再只是聊天工具或图像生成器。它正在进入医疗、金融、电力调度、政府治理、工业生产,甚至军事决策等领域。当这些关键系统越来越依赖AI,而模型、数据和算力又掌握在其他国家或企业手中,技术依赖就可能转化为安全风险。
这种风险也同样存在于文化层面。一个国家即便自行部署了AI模型,如果模型训练所使用的主要数据来自其他国家,模型输出的价值观、叙事方式和知识结构也可能带有外来印记。有学者将这种现象称为“数据殖民”:AI不仅是技术工具,也是文化表达和话语权的载体。
问题在于,建设主权AI并不容易。过去大模型竞争高度依赖参数规模和海外高端GPU,而当前行业竞争正在转向后训练、推理计算和综合效率。对于很多中小国家而言,从零训练一个前沿基础模型并不现实,于是,基于开放模型加入本国语言、文化和行业数据,成为更可行的路径。
但发布一款冠以本土名称的模型,并不代表已经建成完整的AI主权。我们需要持续追问:各国选择了哪些技术路径来搭建主权AI?仅仅依靠本土专有数据,能否构筑起AI主权的根基?而主权AI最终,能否落地形成可持续的商业与产业价值?
主权AI热潮:
各国正在怎样造自己的模型?
CNAS数据显示,指数追踪的国家中,40%只支持1个项目。参与国家的门槛正在下降,2023年主要是欧洲、东亚和海湾地区的富裕经济体,到2026年年中,参与范围已经扩大到67个国家,其中10个首次进入的国家全部属于中低收入经济体,包括柬埔寨、多米尼加、埃及、加纳、尼泊尔、巴基斯坦、巴布亚新几内亚、巴拉圭、菲律宾和乌拉圭。
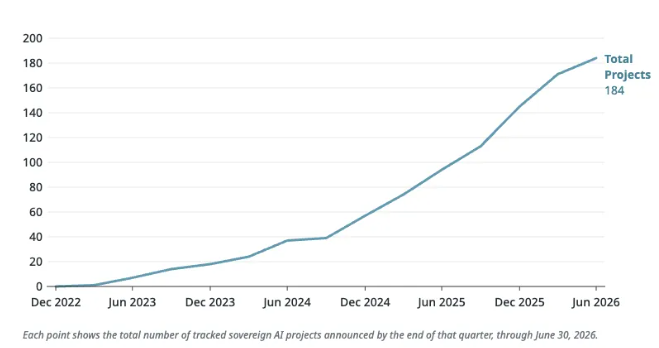
来源:CNAS Sovereign AI Index 2.0。
按照该指数的统计,目前全球约三分之一的国家正在推进某种形式的主权AI。这些国家合计占中美两国之外全球GDP的约90%。这说明,主权AI已经不只是少数国家的政策偏好,而正在变成许多国家必须回答的现实问题。
海外经济体的主权AI建设,按照基础大模型是否从零原生训练的标准,大致分化为三大路径:从零起步的自主原生研发、选用美国开源基座做本土主权项目改造、选用中国开源基座开展本地化二次开发。需要明确的是,后两类项目的权属、部署与数据主权依然归属本国,仅基础模型起点取自外部开源生态。
第一类为自主原生研发路线,代表国家包含俄罗斯、印度与瑞士等。
俄罗斯Sber的GigaChat、Yandex的YandexGPT5Lite以及新版AliceAI,均采用随机权重初始化,在本土算力基础设施上完成完整预训练;
印度本土多语言模型Krutrim‑2参考Mistral‑NeMo架构范式,但模型权重从零开始训练,目标均是跳出英语主导的全球大模型体系,搭建适配本国语言文化、公共服务场景的AI能力。
瑞士则选择从零训练Apertus模型,尽管该模型通用能力不及全球前沿水平,但经过提契诺州针对机密文件翻译场景微调后,在本地涉密业务场景表现优于Meta的LlamaScout。
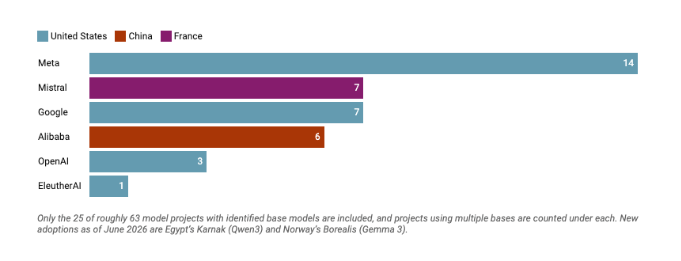
在能够确认基础模型来源的25个主权AI模型项目中,Meta Llama使用最广,阿里巴巴已经进入前列。来源:CNAS Sovereign AI Index 2.0。
第二类是选用美国开源基座打造本土主权AI项目,澳大利亚、智利牵头的拉美区域项目、挪威是典型样本。
澳大利亚Sovereign‑AU推出本土研究模型Ginan,项目主导权归本土机构,以MetaLlama3.1作为基座,使用约2亿token澳大利亚本土法律文献、澳式俚语语料完成微调,面向本土政务、法律服务场景开放,对外明确打出澳大利亚AI主权定位。
拉美区域标杆项目Latam‑GPT,由智利国家人工智能中心CENIA牵头推进,项目主导权、算力托管与运营归属拉美本土,属于区域主权AI基础设施;其技术起点选用Llama3.1‑70B底座,汇集来自20个拉美国家的历史档案、原住民文字等区域专属语料继续训练,目标面向西语、葡语世界提供本土可控AI能力。
北欧挪威NorwAI的挪威语大模型家族,项目权属归挪威本土团队,有多条分支基于Llama2、Llama3底座,注入挪威本地语料,面向北欧政企提供可本地部署的版本。该路线的共同特征是:主权与部署权留在本国,基础模型能力取自美国Meta开源生态,本土团队掌握后续数据微调、运维与落地权限,以此压低算力投入、缩短上线周期。
第三类以中国开源模型作为底座,开展本地化二次开发,沙特、西班牙、新加坡均有代表性项目落地。
沙特HUMAINM3由沙特公共投资基金旗下企业推出,以稀宇科技MiniMax开源模型为底座,依托超万亿Token阿拉伯语语料完成二次训练,重点强化阿拉伯语理解、本土文化适配能力。这一路径主要是,本国主权财富基金支持的企业负责产业化和本地化改造,中国开源模型提供基础能力,沙特语料和文化数据负责提升阿拉伯语表现,最终再通过本地平台向研究人员和政府应用开放。
同时,选择采用中国大模型的国家还有,西班牙MultiverseComputing的Quasar438B,是在智谱GLM‑5.2基础之上,借助模型压缩技术完成调优;新加坡SEA集团SEA‑LIONV4底座源自阿里Qwen。
而德国AlephAlpha的Kolibri属于跨生态混合的特殊样本,难以直接归入前述三类路径。该模型面向政府、工业、航空航天等高监管领域,定位欧洲主权AI:模型主体采用随机权重初始化,完整预训练链路在本土算力环境下完成,基座本体由团队自主训练;但在监督微调(SFT)的合成数据集生产环节,团队调用智谱GLM系列、阿里Qwen等中国开源模型作为“教师模型”,辅助生成、重写指令样本。这和直接加载外部成品权重作为训练起点的模式有本质区别,也恰好揭示主权AI建设的现实复杂性,并非简单非此即彼的二元选择。
这一系列案例共同印证,评判主权AI价值,不能简单以参数规模、通用榜单得分作为标尺。一款模型或许在全球通用推理能力上并不占优,但若贴合本国法规、政务文件、小众语种、涉密资料处理需求,就具备不可替代的落地价值。
专有数据能否撑起主权AI?
各国在主权AI上的路线差异,本质体现的是对“AI主权”内涵的不同理解。俄罗斯、印度更强调底层基座构建与长期产业主导权;新加坡、澳大利亚、西班牙等经济体,重心放在模型部署、治理框架搭建与行业场景落地;低收入国家则优先补齐本土语言数据集、应用开发能力与本地服务自主权。
主权AI并非在“完全自研”和“完全依赖外部技术”之间做二元取舍,而是一套分层的能力集合。评判一国是否具备AI主权,不能仅凭是否拥有一款冠名自研的模型,核心在于能否掌握模型落地本国社会之后的关键管控环节。
在此背景下,不少国家选择“他国开源基座+本国专有数据”的技术路线,这也引出一个核心问题:仅依靠专有数据,能否支撑起主权AI建设?
回答这个问题,首先要厘清本地数据能够带来的改变。本地数据最直观的价值,是塑造语言与文化层面的差异化。一国未必需要训练全球最强通用模型,但依靠本土语料,可以让模型更精准理解本国用户日常语言习惯。
与此同时,本土制度类数据,决定模型在政务与公共服务场景的可用性。法律、财税、社保、教育、医疗规则具备极强地域属性,通用模型自带的全球知识库无法替代本土制度认知;模型读懂本国政务表单、法律术语、办事流程的能力,直接决定其能否进入公共服务体系。
本土产业数据,则可用于构建垂直领域能力。能源调度、港口物流、金融合规、制造工艺、农业生产等场景高度依赖行业知识。中小国家很难在通用大模型赛道实现赶超,但只要掌握本国核心产业数据,就有机会打造面向政务、能源、交通、金融领域的专业模型。
但专有数据不等于高质量数据,更不等于完整AI主权能力。数据建设本身存在多重硬性约束:第一是合规约束,政务文档、企业档案、医疗记录与个人信息,需要守住版权、隐私与安全红线;第二是质量约束,过时法条、错误译文、未经核验的网络文本,会放大模型在本土场景的出错风险;此外还需要持续迭代能力,政策、产业流程、语言表达持续动态变化,如果仅在模型发布阶段一次性灌入本地数据,后续缺少常态化的数据采集、清洗、评测机制,所谓主权模型很快丧失实用价值。
合成数据的普及则进一步增加议题复杂性。本地数据集未必全部由本国研究者原生产出,其中可能包含外部大模型生成的合成数据。一旦模型大量使用外部模型产出的数据训练,就需要单独评估:模型核心能力是否真正来源于本土数据,会不会继承原有基座固有偏见,是否存在数据污染隐患。
由此可见,不能简单将“接入本地数据”等同于形成独立主权AI能力。判断的核心标准,是这批数据是否真正重塑模型的知识结构、语言能力与任务表现,并且能够通过独立评测验证效果。
专有数据只能承担主权AI建设中的一部分支撑作用,无法独立形成完整的AI主权。主权AI的落地,需要模型权重、算力、部署体系、安全机制、评测体系与治理能力共同形成完整闭环。
主权AI有没有
真实的商业与产业价值?
主权AI究竟是现实能力,还是政策和市场噱头,最终要看它能不能进入真实业务。
最直接的应用场景是政府和公共服务。税务、社保、教育、医疗、移民、司法等公共事务,都需要处理大量本地语言和本地规则。如果模型能够在本国部署,政府就可以更好地控制数据访问、模型权限、操作日志和责任边界。
对沙特而言,HUMAINM3的价值不只是阿拉伯语对话能力,还包括对沙特文化、本地政府服务和“2030愿景”相关产业的支撑。对于新加坡和东南亚国家而言,SEA-LION的价值也不只是提供一个多语言聊天工具,而是帮助政府和企业处理区域语言、公共服务和本地知识。
主权AI目还可能会带动本土AI产业链成长。项目落地会倒逼本地数据治理、模型部署、云平台、网络安全、算力中心与人才培养体系建设。即便一个国家最终没有训练出全球顶尖基础模型,依然有机会围绕政务、教育、金融、工业场景,搭建一套本土AI服务体系。
但主权AI的商业化也存在明显限制。首先是市场规模问题。很多中小国家的本地语言用户数量有限,模型训练、评测、部署和维护却需要长期投入。如果模型只能服务本国政府,而没有跨境输出能力,商业收入可能难以覆盖成本。
AI项目落地的后续维护也是一大问题。法律会更新,政府流程会变化,产业数据会过时,模型也需要不断进行安全修复和性能评测。主权AI不是发布一个模型文件就结束,而是持续运行的基础设施。
再次是底层依赖问题。即使一个国家掌握了本地数据和应用,也可能仍然依赖外部GPU、云服务、模型架构和开发工具。如果这些关键环节无法掌握,那么它获得的更可能是“本地化AI能力”,而不是完整的AI主权。
此外,政府项目也容易出现展示化倾向。模型发布时可能有参数规模、训练数据量和排行榜成绩,但真正落地后,只有问答演示、内容生成或少量试点,尚未进入高频业务流程。主权AI是否具有产业价值,不能看发布会上的模型名称,而要看它是否被政府部门、企业和开发者持续使用。
中关村论坛发布的《全球主权大模型发展白皮书》提出,主权AI应当包含开放、协作、可控和普惠四大理念,并以开源通用基础模型为底座,向上建设应用开发平台和工具链,向下推进与硬件伙伴的基础设施协同,同时支持不同部署模式。这套思路实际上反映了主权AI的现实方向:完全封闭的技术自主很难实现,跨国合作不可避免,但关键数据、关键应用和治理责任需要保留在本国或区域体系内。
因此,主权AI的真实价值,不在于每个国家都训练出一个参数规模最大的模型,而在于它能否在关键领域保留自己的语言能力、知识体系、数据边界和技术选择权。
回到开篇的问题,搞点专有数据,确实可以做出一个本地化AI;但仅靠专有数据,还做不出完整的主权AI。
真正的主权AI,需要模型、数据、算力、部署、治理和产业应用共同形成闭环。它不一定要在所有榜单上超过GPT、Claude或其他前沿模型,但必须能够在本国关键场景中稳定运行,理解本国社会,保护本国数据,并承担相应责任。
未来的主权AI更趋向一种融合形态:以全球开放模型生态为基础,叠加本土知识系统与国家级治理框架。这场探索不会全盘成功,也不会全部沦为概念噱头。大浪淘沙之下,能够长期存续的项目,不会是那些高喊“主权”口号的项目,而是真正落地政务与产业场景、持续迭代数据资产、培育本土开发者生态,在全球大模型的竞争浪潮中,稳步沉淀本国长期数字能力的AI体系。
文:几重山月 / 数据猿
责编:凝视深空 / 数据猿
来源:数据猿
刷新相关文章































我要评论
不容错过的资讯



大家都在搜


