

数据采集搬进客厅,宝妈成为主力军?
【数据猿导读】 “具身数据的采集,正在走进快递站、制衣厂和宝妈的客厅。
“具身数据的采集,正在走进快递站、制衣厂和宝妈的客厅。
一边踩刹车,一边踩油门。
数据采集中心这头,先熄了火。8月28日,北京首个人形机器人数据训练中心停止运营。这座中心位于石景山首钢园,2025年3月揭牌时,规划了3000平方米场地、108台机器人、十大实景场景,区里曾预期年数据交易超过100万条,三年形成50亿元的数据服务市场。运行不到18个月,核心合作方睿尔曼智能撤走了全部自有设备。
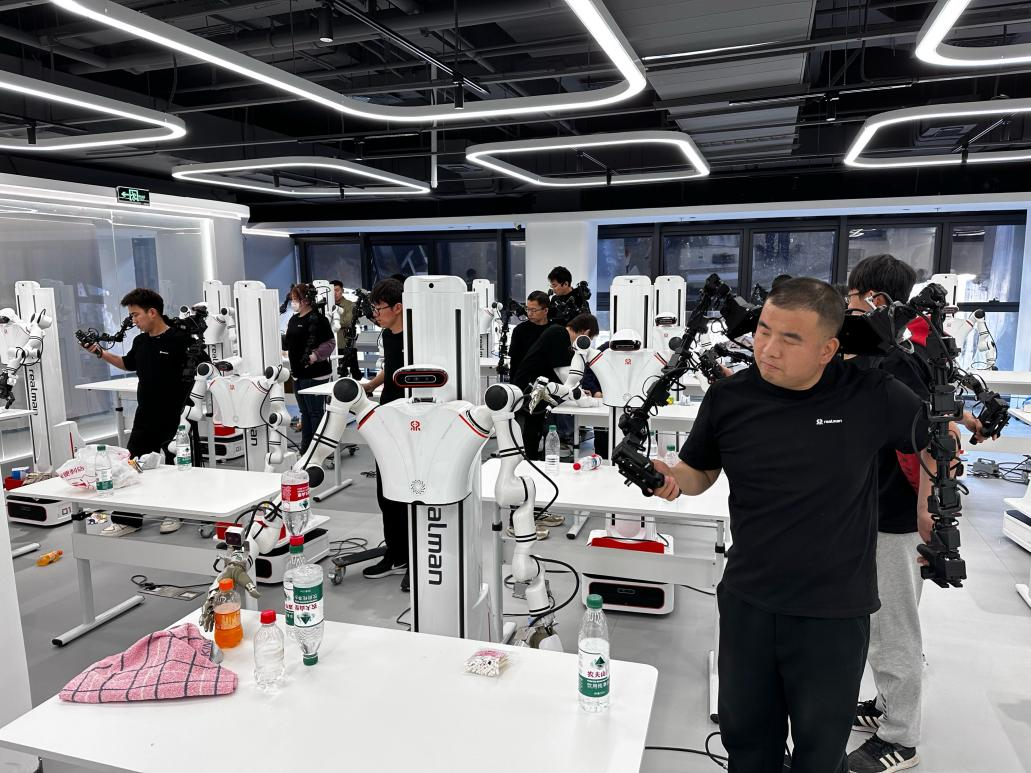
北京首钢园人形机器人数据训练中心 来源:北京日报
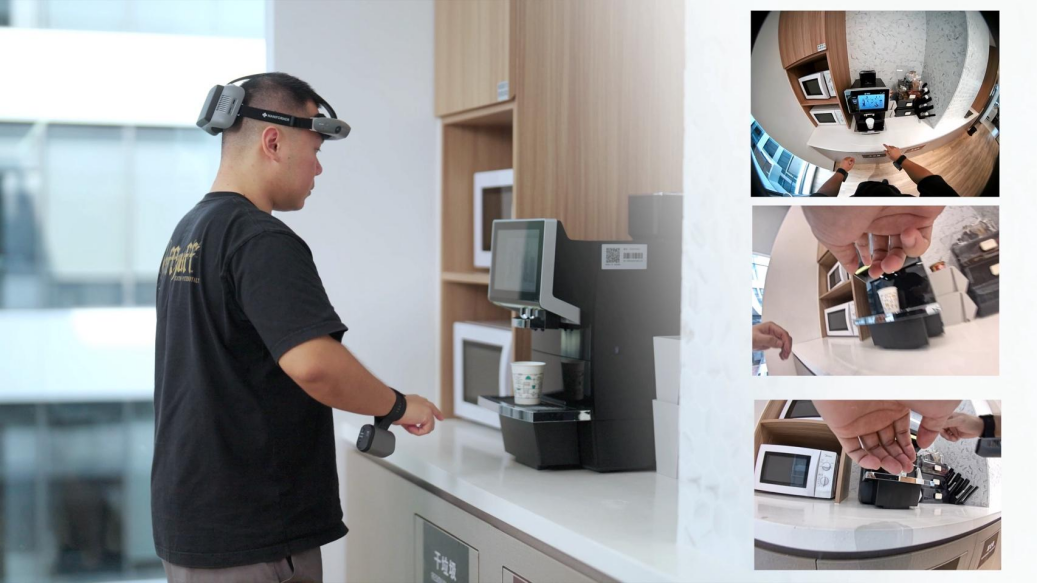
但无本体采集(指不依赖完整的机器人本体进行数据采集)在猛蹬油门。8月31日,智元旗下的觅蜂科技把第2万套无本体采集设备交付给京东,宣布累计生产超过100万小时无本体数据。9月23日,觅蜂派上线,个人用户可以直接注册接单。同时,京东在江苏宿迁计划发动超过10万名市民参与采集。
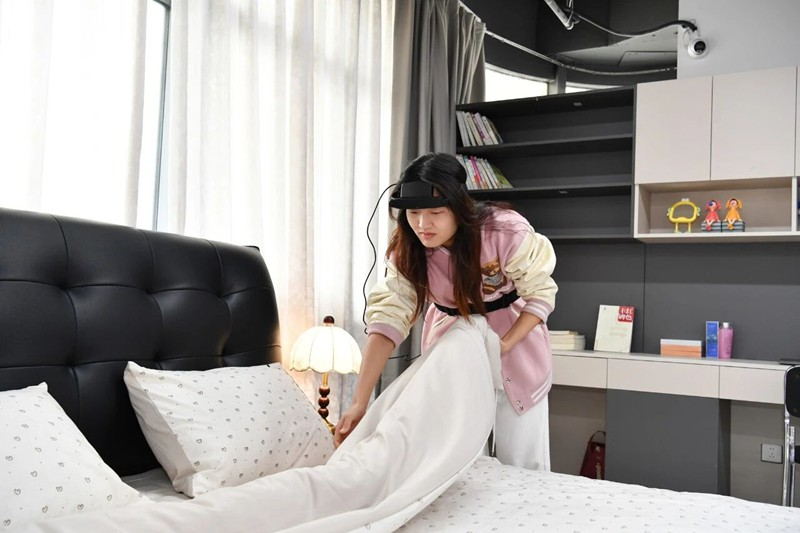
居民头戴京东JoyEgoCam采集终端 来源:京东机器人数据采集中心
一个数据中心熄了火,万千居民戴着设备准备开工。这是一个真实的趋势,还是个别案例被夸大了?它有多普遍,又占据多大比例?背后是什么在推动,谁在做,又会把具身智能引向哪里?下面逐一拆开分析。
数据采集中心
关门的少,转向的多
先看总量。据虎嗅统计,建设高峰出现在2026年一季度,此后新项目明显减少,截至2026年8月,全国公开披露的集中式数采中心共106家,其中84家已投入运营,占79.25%。中国信通院的统计口径略有不同,截至26年6月底,已投入运营的训练场超过70个,另有46个在规划或建设中。从这些数字看,并没有出现大规模的“倒闭潮”,公开信息里完整关停的案例也很少,首钢园停运后也在改造重启。

首钢园升级后的训练中心内景 来源:北京日报
但没倒闭不等于跑得通,这四道关还没跨过去。
第一是回本。信通院的报告测算,假设一座训练场投入5000万元、每年产出10万小时数据并且全部卖出,仅靠数据销售收回投入,仍需三年以上,而现实里很难全部卖出。
第二是效率。智元的姚卯青说,一名专业遥操员一天工作8小时,平均只能产出2到3小时有效数据。
第三是买家。虎嗅询问多家运营方,得到的回答基本一致。真正愿意持续购买数据的客户比较少,头部本体公司(指需要依赖完整的机器人本体进行数据采集的企业)大多在建自己的数采体系,中小企业又很难长期承担大规模真机数据的成本。
第四是数据本身。采集中心只采用单一品牌机器人,数据格式互不兼容,换一个机器人本体往往要重新采集。采集环境太过于干净,机器人的环境泛化能力一般。采集数据多为“片场数据”,这些数据光照恒定、地面平整、物体摆位规整,采出来的和真实世界差得很远。
所以,比起“倒闭”,更准确的说法是“换向”。一座座样板间式的数采中心,正在被迫回答,数据能卖给谁,数据又能值多少钱这个问题。
哪种数据采集才是主力?
到底谁是主要一方,需要分开计算。
目前没有机构公布过完整占比。根据公开披露的中心数量、数据产出和价格区间推算,2026年外部付费的有效数据里,集中式的采集数据大约为25万到60万小时,分布式的采集数据大约为100万到400万小时。按小时数说,分布式已经占到约八成,集中式剩下两成左右。但按金额算就不一样了。真机数据一小时500到1000元,无本体数据100到400元,前者是后者的三到五倍。按金额估,集中式占五成多,分布式四成多。
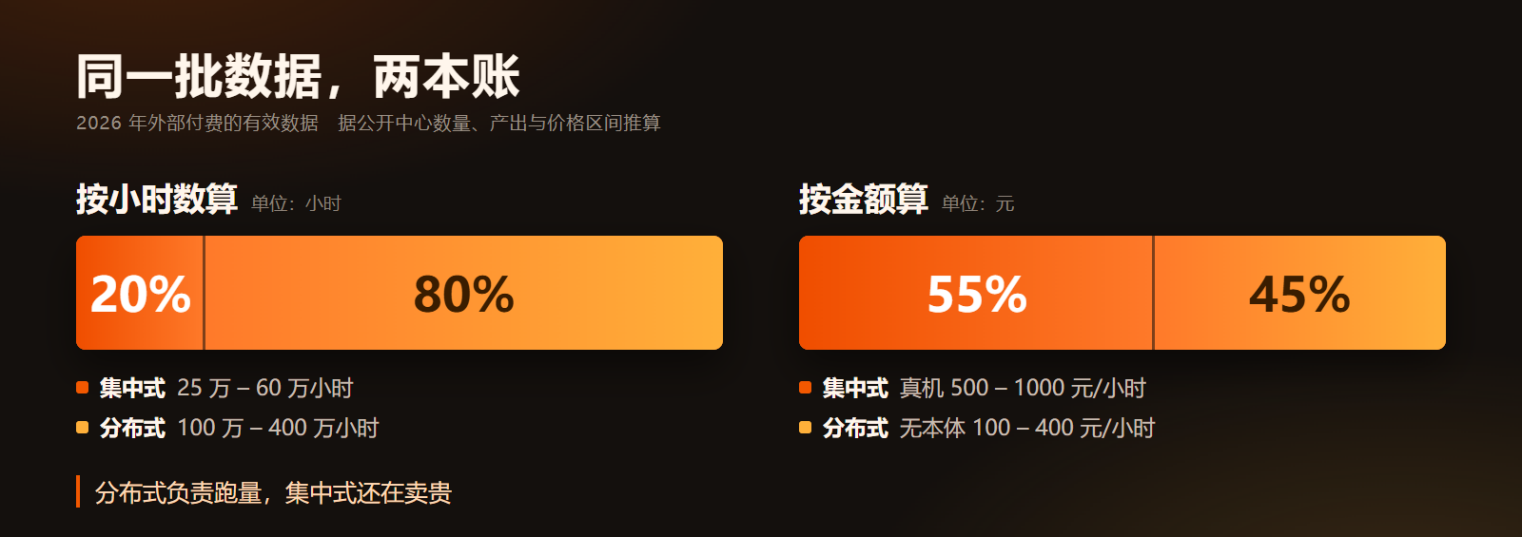
同一个市场,两套算法,两个答案。分布式在跑量,集中式在跑价。分布式像便利店,网点多、周转快、单价低,一斤一斤往外称。集中式像专业实验室,单价高、流程重、设备贵,单子一份一份往外签。
需要特别说明,本文所说的“分布式”,包括企业自有员工、定点采集员和众包用户,并不等于全部都是个人兼职。公开资料也没有给出纯众包的独立占比。因此,更稳妥的判断是,兼职和众包已经成为无本体数据采集的重要劳动力来源,也是增长较快的一部分。
为什么机器人
需要大量的“人类代练”?
第一,成本。真机遥操要买机器人本体,动辄十几万、几十万元一台,无本体采集只需要一套头显和夹爪,单套设备成本在2万元左右。觅蜂的姚卯青称,无本体数据的单小时成本,已经低于仿真数据。集中式的账则越算越难,遥操员一天8小时只有2到3小时的有效数据。
姚卯青在觅蜂派全球发布会上讲话 来源:觅蜂科技
第二,数据的真实性。数采中心里光照恒定、地面平整、物体摆放规整,采的是“片场数据”,而模型公司和本体厂商要的,是难例、失败恢复、接触力反馈和长尾分布。信通院的报告也发现,家庭场景的采集任务,仍然集中在叠衣服、叠毛巾、桌面整理这几类。真实产线里,零件反光、油污、摆放偏差,都是集中式场馆很难复现的。
第三,需求的量级变了。机器人企业、大模型企业等客户的数据需求,已经从百万小时迈向千万小时。按行业测算,要让机器人单个技能点达到可交付水平,可能需要2000至5000小时的训练数据。按这个量级,几十万小时的集中式产能远远不够,必须把采集铺进成千上万个真实场景。
所以,实践足以证明,机器人的“老师”是人,而不是机器人。
宝妈上岗
这批人是谁,能挣多少
京东的采集员最有代表性。据财联社报道,京东在社区的采集人员以50岁以内的本地居家人员为主,全职宝妈占比最高,每天工作6小时算全职,月收入稳定在4000元左右,线上报名、线下培训1至2天就能上岗,按有效作业时长计薪。
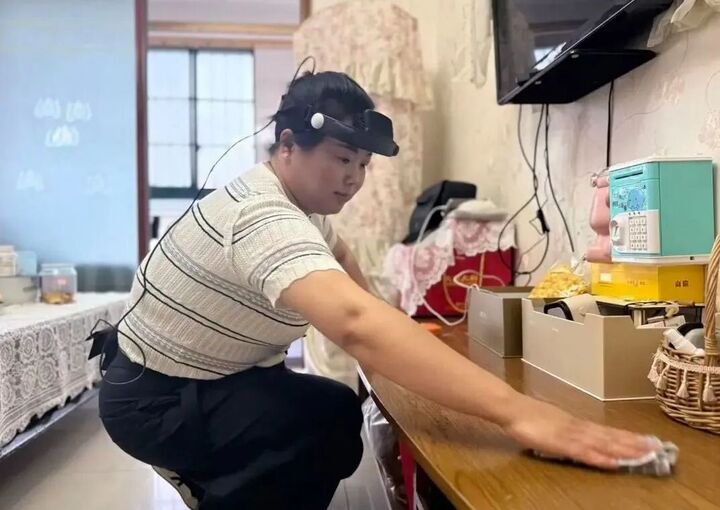
全职宝妈在自家客厅擦桌 来源:今日头条
在宿迁的制衣厂里,缝纫女工头戴采集设备,一边干活一边采集,工作日采集6小时左右,一个月能拿到四千多元。京东的计划是发动内部超过10万名不同职业的员工,外部最多50万人参与,其中宿迁的数采中心计划动员超过10万名市民,目标是一年内积累500万小时人类真实场景视频,两年内突破1000万小时。

缝纫女工头戴采集设备 来源:每日财经
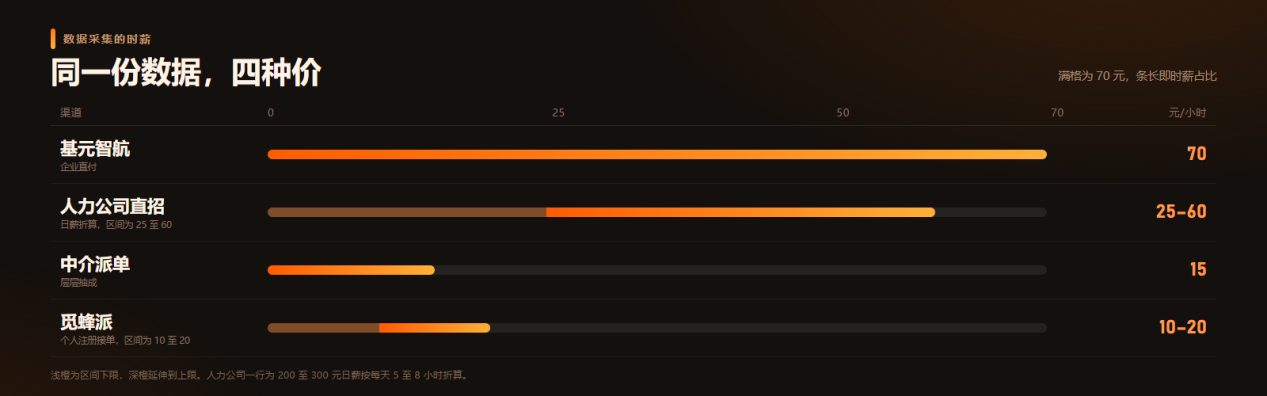
但不同渠道的收入差得很远,而且还在往下走。企业直聘能到70元一小时,中介派单到手只有15元一小时,通过平台接单时薪是10到20元不等。并且部分接单软件入场还要押金,芝麻信用700分以下,要先押5000元。有记者实测,一天下来还倒亏了10元。
价格趋势也不乐观。36氪的一篇报道提到,众包采集的有效时长价格,3月初是每小时50元、要求每天采集不少于8小时,到近期已经低至每小时20至22元。有行业人士估算,付给采集员的报酬加上培训、审核等,厂商的总成本约每小时100元,对外售价约200元。
所以,数据采集员是一份门槛低、自由度高的零工,也是一份收入不稳定、没有统一标尺的零工。在宣传里是月入三四千,但实际到手可能只有15元一小时。
数据从场馆搬到人身上
多了什么,少了什么
好处是明显的。
首先是规模。京东的目标是一年500万小时、两年1000万小时。觅蜂累计产出超100万小时无本体数据,设备出货2万套,并提出2026年千万小时级产能。简智机器人采集产线覆盖3000多名采集人员、上万个真实场景,单季度有效数据交付也跃升至百万小时。鹿明机器人计划投放1万台背包版UMI设备,目标达到百万小时级数据产能。穹彻智能用手机做“口袋集采”,上半年推广到全国50多个城市、合作超1万素材人员,积累了几十万小时真实数据。帕西尼累计已超100万小时的触觉数据,并计划向千万小时级实采数据迈进。它石智航通过穿戴式套件Sense Hub采集,在今年7月,也达到了“百万小时级”。
这些数字口径并不统一,有的是累计交付,有的是单季有效数据,有的是年产能或目标产能,但指向同一个事实,采集场景从工厂搬进客厅后,数据规模的上限整体抬高了一个数量级,采集能力从万小时级直接跨到百万小时级,下一步目标是千万小时级。
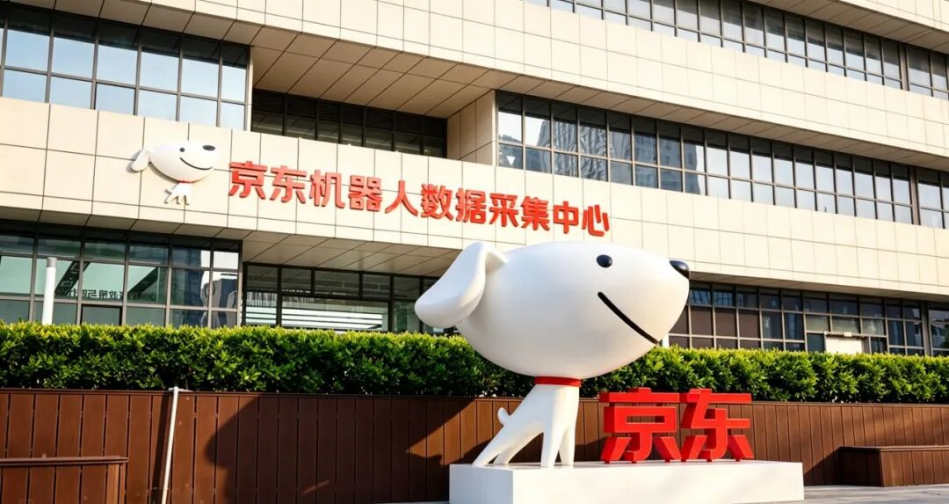
京东机器人数据采集中心门头 来源:每日财经
但风险也是并存的。
第一,无本体数据缺少机器人自身的动作和力觉信息。遥操作数据能让机器人通过物理交互学习,这是视频做不到的。并且仍有约三成的机器人买家,只愿意购买基于UMI夹爪(指手持式、模仿机器人末端执行器形态的轻量化夹爪)的数据。所以未来的分工可能是无本体数据做预训练,真机数据做后训练,而不是谁替代谁。北京人形机器人创新中心的数据基地70%以上的产能服务行业客户,也说明真机数据仍然有人买。
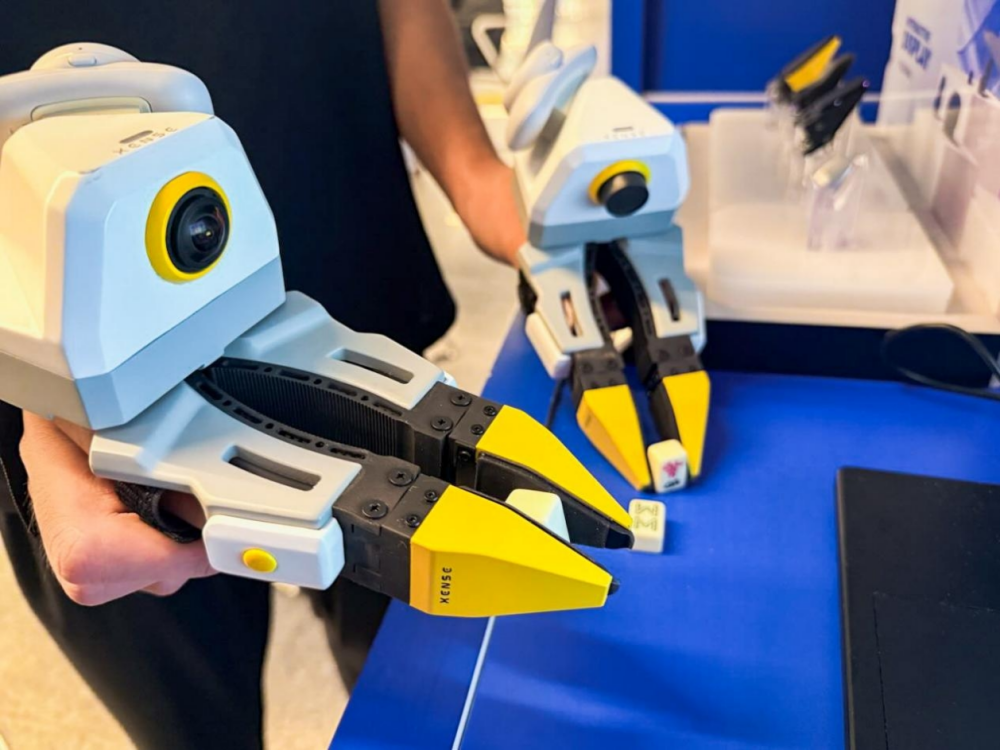
手持UMI采集夹爪,夹爪上带相机与轨迹记录 来源:东方财富财富号
第二,数据质量。普通场景的数据已经接近饱和,但工厂、高危作业等垂类场景的数据仍然稀缺。众包链条长、环节多,其中存在大量无效和重复数据。也就是说,小时数涨得很快,有用的小时数不一定跟得上。
第三,合规与劳动权益。家庭场景的采集绕不开隐私,采集会拍到住所、家人等。觅蜂的做法是端侧加密、原始数据本地脱敏、云端二次清洗、分级存储,但目前行业还没有统一的标准。
第四,经济可持续性。时薪10至20元的报酬,对应的是每天19元的设备租金和有限的任务,对个人来说,这是一份要自己找活、自己找场景的零工,能不能稳定做下去,要打一个问号。
数据这门生意,谁在做?
本体厂商孵化的新企业。觅蜂科技是智元2月拆分出来的,成立十天就完成数亿元种子轮和天使轮融资,红杉中国领投。它的MEgo设备已出货2万套,累计产出超过100万小时无本体数据,客户包括京东、腾讯Robotics X实验室、蚂蚁灵波,众包业务已在40个城市落地。它石智航则同步研发本体、具身大模型和穿戴式采集系统,4月融资后投后估值约130亿元。
觅蜂的MEgo系列 来源:觅蜂科技
专业数据创业公司。简智机器人2025年5月成立,一年内完成7轮融资,累计超过2亿美元,8月的A轮由Momenta领投,此前蚂蚁、滴滴也领投过,已开源超过1.3万小时无本体数据集。鹿明机器人计划投放1万台背包版UMI设备,穹彻智能推出用手机就能采集的“口袋集采”,正在小规模众包测试,帕西尼则专攻触觉数据。

简智机器人DAS系列三件套 来源:智东西
大模型巨头。京东搭了一个“数据金字塔”,最底层是千万小时量级的第一视角视频,来自全国3600多个仓库和上万家线下门店的日常作业。蚂蚁灵波把采集任务直接分发给众包,靠平台调度去获得数据。腾讯则更多站在买方位置,自己不下场建队伍,按需买数据集,拿钱办事。

京东机器人数据采集中心的门店药房场景 来源:新华社
转型的老场馆。集中式的运营者也在转向。睿尔曼智能把遥操搬到常州的真实场景里,30多台机器人已部署到工厂产线和仓储物流。北京人形机器人创新中心的数据基地,年产能18万小时,已对外交付近3万小时,70%以上产能服务行业客户。

睿尔曼常州数据采集中心的全景 来源:睿尔曼智能官网
未来,数据采集会走向何方?
集中式不会消失,但会瘦身分层。有内部模型训练需求托底的自建基地、拥有稳定客户的第三方中心、能处理异构本体和跨本体数据的公共训练场,会留下来。主要依赖一次性建设资金、缺少持续订单的中心,会被淘汰或转型。首钢园的“停运、改造、重启”,大概率不是个例。

石景山首钢园人形机器人数据训练中心外景 来源:人民网
分散式采集会继续扩张,但进入比拼质量和标准的阶段。前半程拼的是人数和设备数,后半程拼的是任务匹配、自动质检、设备减重、合规流程和验收标准。价格还会继续下探,能活下来的,是有渠道、有质检能力、有稳定买家的头部公司。
买卖的逻辑,从小时转向效果。买方越来越关心的,是数据能给任务成功率带来多少提升,而不是采了多少小时、用了多少台机器人。这对集中式和分散式都是考验。
回到文章的开头“数采中心倒闭,宝妈上岗了?”前半句不完全准确,但后半句却是事实。宝妈、快递分拣员、制衣厂工人等普通人加入采集大军,说明想让机器人学会干活,就需要有人把活先干给机器人看。但问题是,我们有没有认真算过这些“老师”的劳动价值?只有劳动者的价值被认真对待,仿真机器人的道路才能走得更远。
文:冯思涵 / 数据猿
责编:凝视深空 / 数据猿
来源:数据猿



我要评论
不容错过的资讯




大家都在搜


